云存储服务的分布式文件系统架构
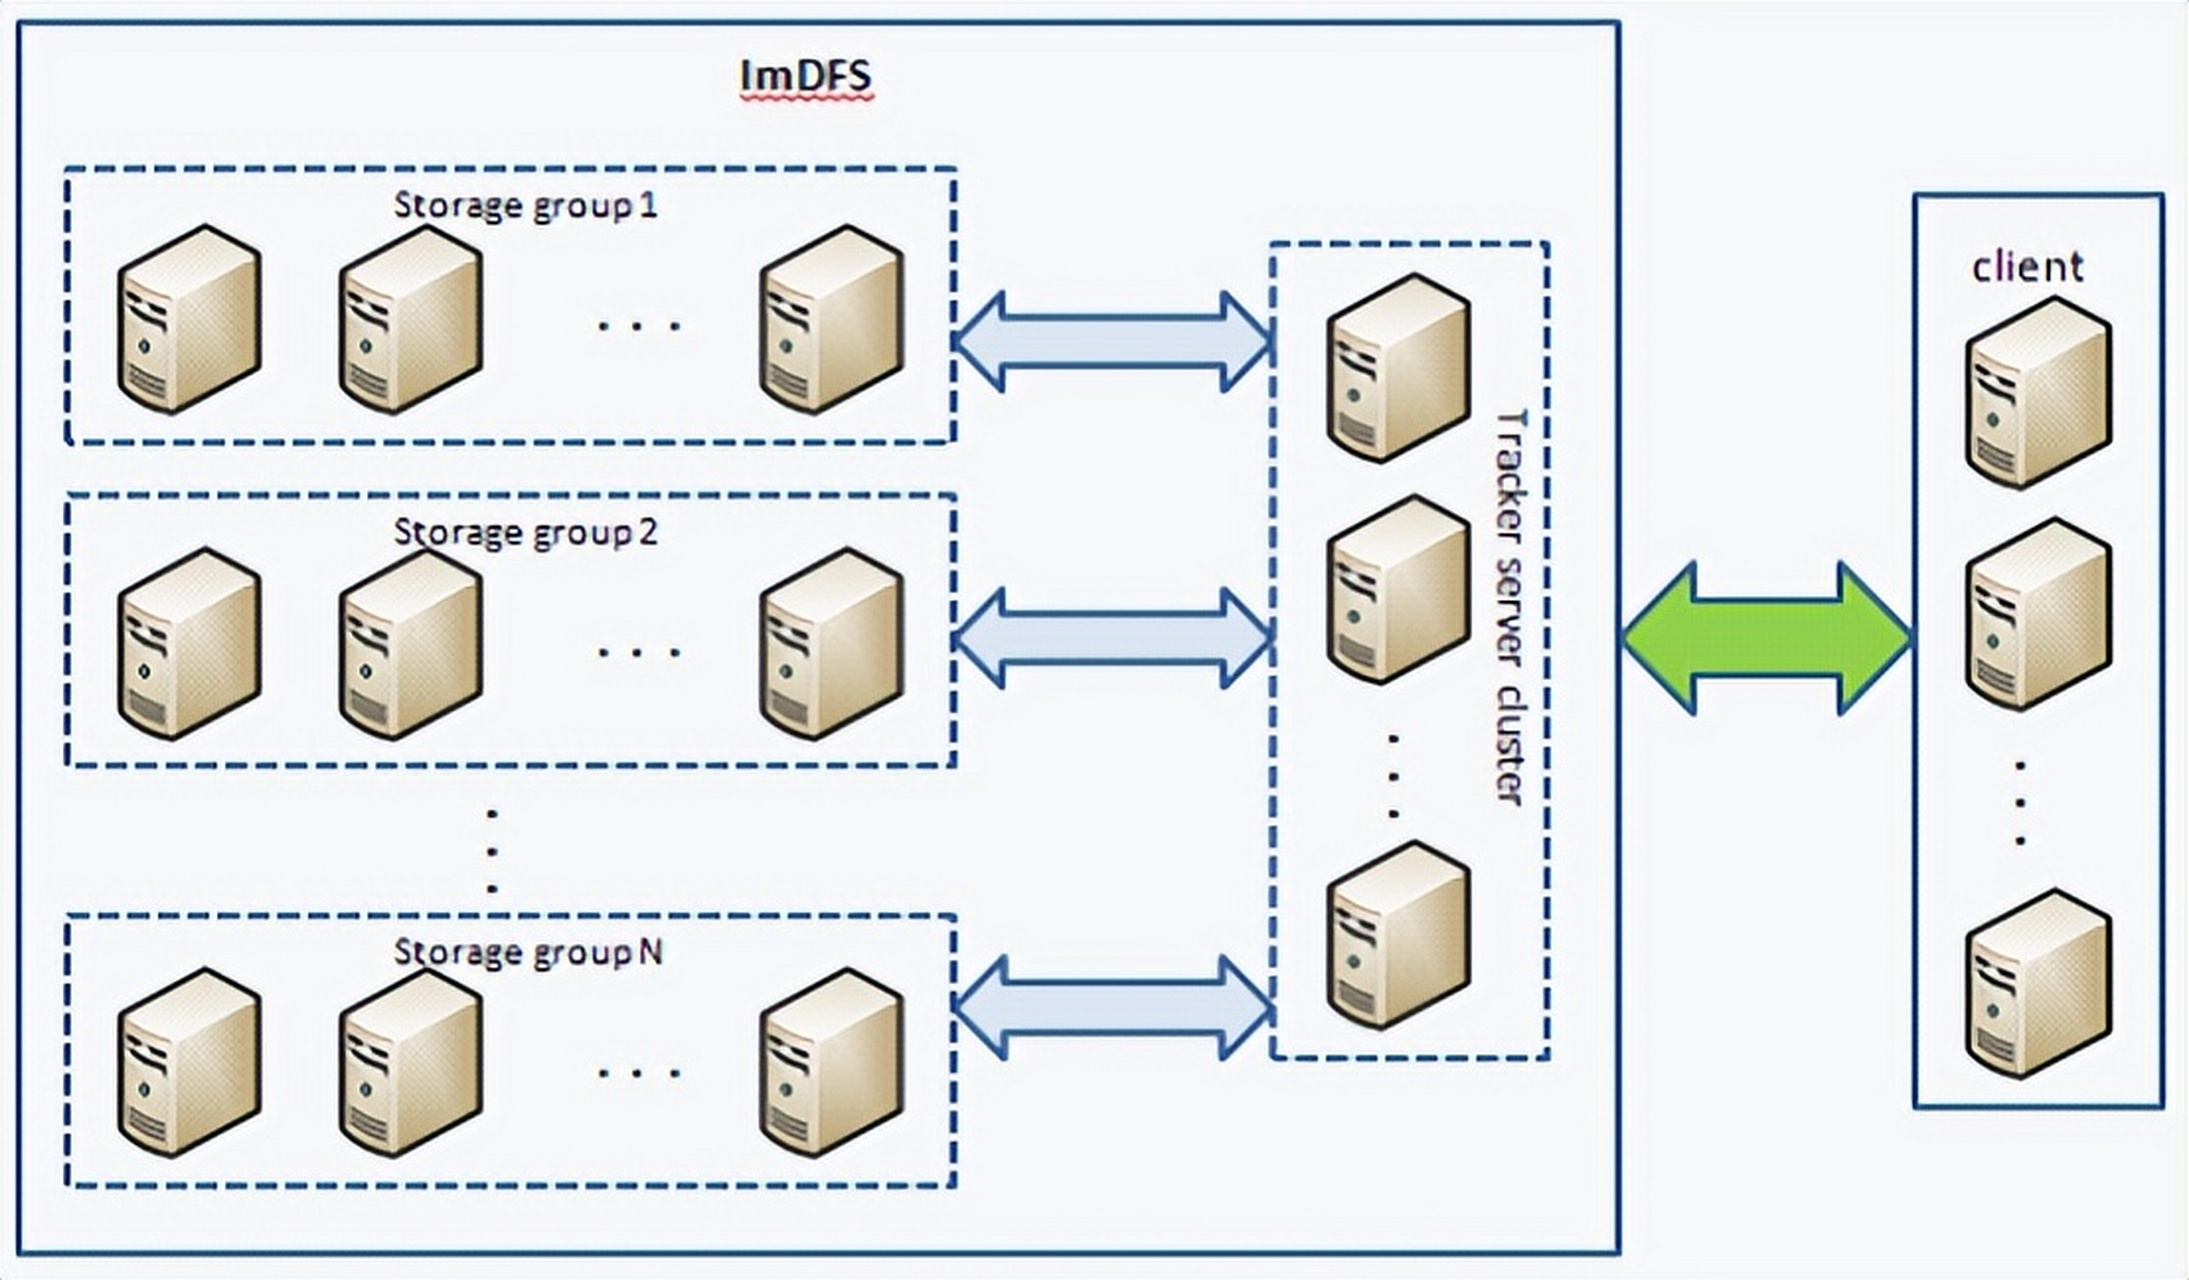
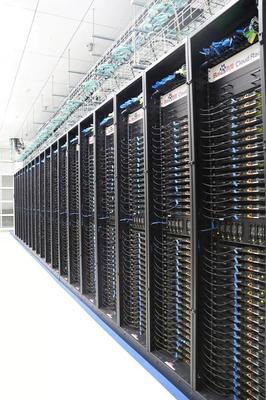
分布式文件系统是云存储服务中关键的存储服务基础设施,它通过将数据分散存储在多个物理节点上,实现了高可靠性、高可扩展性和高性能的数据访问。以下是云存储服务中分布式文件系统架构的详细解析:
一、架构概述
分布式文件系统架构通常采用主从模式(Master/Slave)或无中心模式(Peer-to-Peer)。主从模式中,一个主节点(NameNode/Master)负责管理元数据(如文件目录、权限、块位置),多个从节点(DataNode/ChunkServer)负责实际数据存储。无中心模式则没有单点瓶颈,但一致性维护更复杂。云存储服务大多采用改良的主从架构,如GFS、HDFS、Ceph等。
二、核心组件
- 元数据服务器(Metadata Server):存储文件系统的命名空间、文件与块的映射、块位置等信息。为保证高可用,通常采用主备热备或分布式共识协议(如Paxos、Raft)实现多副本。
- 数据节点(Data Node):实际存储数据块,每个数据块通常有多个副本(如3副本),分布在不同机架或可用区,以容忍硬件故障。
- 客户端(Client):通过元数据服务器获取文件块位置,然后直接与数据节点进行数据读写,减少元数据服务器负载。
- 块存储层:文件被切分为固定大小的块(如64MB或128MB),每个块有唯一ID。块存储简化了存储管理,并支持并行读写。
三、关键机制
- 数据冗余与容错:通过多副本或纠删码技术实现数据持久性。多副本简单但存储开销大;纠删码节省空间但重建开销高。云存储常根据数据热度混合使用。
- 一致性模型:分布式文件系统通常提供弱一致性或最终一致性,以提升可用性。例如,HDFS采用“一次写入,多次读取”模型,保证写入后可见。
- 负载均衡:元数据服务器动态调度数据节点间的负载,避免热点。数据节点定期汇报心跳和块报告,元数据服务器据此迁移或复制块。
- 扩展性:通过增加数据节点线性扩展存储容量和吞吐量,元数据服务器可采用联邦或分片机制扩展元数据能力。
四、典型架构示例
- Google File System (GFS):单Master、多ChunkServer,针对大文件、追加写优化,是Hadoop HDFS的原型。
- Hadoop HDFS:主从架构,NameNode+DataNode,适合批处理,高吞吐,但低延迟场景不适用。
- Ceph:无中心元数据设计(CRUSH算法),支持对象、块、文件统一存储,高扩展性和自修复能力。
- 阿里云盤古:阿里云自研分布式文件系统,采用多副本+纠删码,支持超大规模集群,提供高可用和低延迟。
五、挑战与发展趋势
- 元数据性能瓶颈:大规模文件数量下,元数据操作成为瓶颈。解决方案包括分布式元数据、内存缓存、分级存储等。
- 跨地域同步:多区域部署需求增加,需要跨域复制和一致性协议支持。
- 异构硬件融合:SSD、HDD、NVMe等混合存储,系统需智能分层。
- 与云计算深度融合:支持容器、Serverless等新型计算模式,提供POSIX兼容或专用API。
六、
分布式文件系统是云存储服务的基石,其架构设计直接影响存储服务的可靠性、扩展性和成本。随着AI、大数据和边缘计算的发展,分布式文件系统将向更智能化、自动化、多云融合的方向演进。
如若转载,请注明出处:http://www.zcbb365.com/product/52.html
更新时间:2026-10-03 14:51:20